AI không còn chỉ là văn bản
Thế hệ AI trước đây chủ yếu tương tác bằng văn bản.
Người dùng nhập câu hỏi.
AI tạo câu trả lời.
Nhưng thế giới thực không chỉ tồn tại dưới dạng chữ.
Con người tiếp nhận thông tin bằng:
- Hình ảnh.
- Âm thanh.
- Ngôn ngữ.
- Chuyển động.
- Không gian.
- Video.
Vì vậy, AI ngày càng được phát triển theo hướng đa phương thức — multimodal.
Multimodal AI là gì?
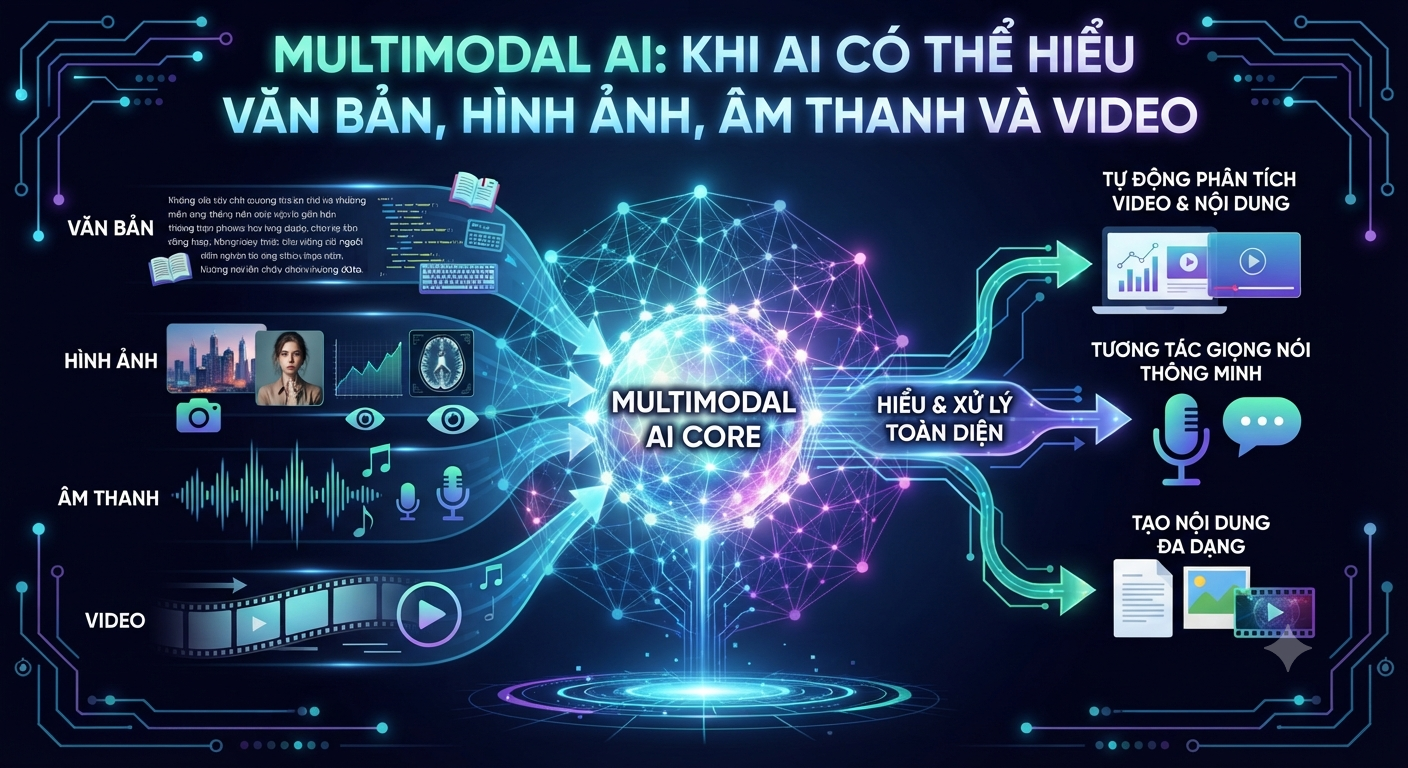
Multimodal AI là hệ thống có khả năng xử lý nhiều loại dữ liệu khác nhau.
Ví dụ:
Văn bản + hình ảnh
Người dùng đưa ảnh một thiết bị và hỏi:
“Thiết bị này có vấn đề gì?”
AI có thể phân tích hình ảnh kết hợp với câu hỏi.
Hoặc:
Video + âm thanh + văn bản
AI có thể phân tích một video, nhận biết các sự kiện, đọc lời thoại và tạo bản tóm tắt.
Tại sao multimodal quan trọng?
Thế giới thực là multimodal.
Một bác sĩ quan sát hình ảnh y tế, đọc hồ sơ và nghe thông tin từ bệnh nhân.
Một kỹ thuật viên quan sát máy móc, nghe tiếng động và đọc thông số.
Một người lái xe phải xử lý hình ảnh, âm thanh, bản đồ và trạng thái phương tiện.
Nếu AI có thể kết hợp nhiều loại dữ liệu, nó sẽ có khả năng tương tác với thế giới thực tốt hơn.
Multimodal và robot
Robot là một lĩnh vực đặc biệt quan trọng.
Một robot không thể chỉ hiểu câu lệnh bằng văn bản.
Nó cần:
- Nhìn.
- Nghe.
- Xác định vị trí.
- Hiểu môi trường.
- Lập kế hoạch chuyển động.
- Thực hiện hành động.
Đây là nơi multimodal AI có thể kết hợp với robotics.
AI video sẽ phát triển mạnh
Video chứa lượng thông tin lớn hơn hình ảnh đơn.
Một hình ảnh cho biết một trạng thái.
Video cho biết quá trình thay đổi theo thời gian.
AI có thể sử dụng video để hiểu:
- Chuyển động.
- Hành vi.
- Sự kiện.
- Quan hệ giữa các đối tượng.
- Trình tự hành động.
Đây có thể là một thành phần quan trọng đối với các hệ thống AI có khả năng hiểu thế giới.
Kết luận
Multimodal AI đang đưa AI gần hơn với môi trường thực.
Từ chatbot chỉ xử lý chữ, AI đang trở thành hệ thống có thể tiếp nhận nhiều dạng thông tin và kết hợp chúng.
Trong tương lai, giao tiếp với AI có thể không còn bắt đầu bằng câu hỏi văn bản mà bằng hình ảnh, giọng nói, video hoặc trực tiếp từ môi trường xung quanh.
FAQ
Multimodal AI là gì?
Là AI có khả năng xử lý nhiều dạng dữ liệu như văn bản, hình ảnh, âm thanh và video.
Multimodal có phải AGI không?
Không. Multimodal là khả năng xử lý nhiều phương thức dữ liệu, còn AGI là khái niệm rộng hơn về trí tuệ tổng quát.
AI có thể hiểu video không?
Các hệ thống AI hiện đại có khả năng phân tích nhiều nội dung trong video, nhưng mức độ hiểu còn phụ thuộc vào hệ thống và nhiệm vụ.
Multimodal có quan trọng với robot không?
Rất quan trọng vì robot phải tương tác với môi trường thông qua nhiều loại thông tin.